El iPad 2 y el iPhone 5 tendrán un procesador de doble núcleo

martes, 18 de enero de 2011

La potencia gráfica también se verá incrementada, al igual que la capacidad para procesar vídeos

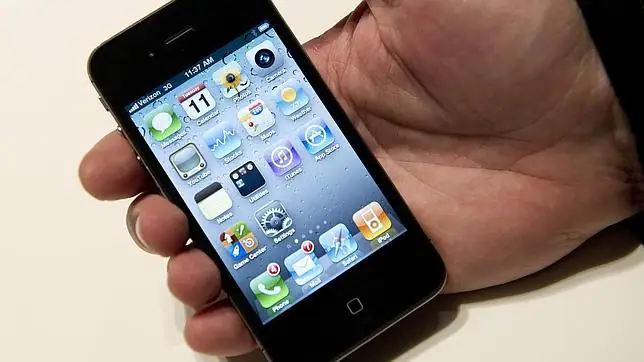
Apple lanzará el iPhone 5 y el iPad 2 con una nueva versión del procesador A4, utilizado en las dos anteriores versiones del smartphone. La potencia gráfica también se verá incrementada, al igual que la capacidad para procesar vídeos. La nueva versión de iOS 4.3 está orientada a ser la receptora de estas nuevas mejoras de hardware.
El iPhone 5 traerá una actualización del procesador A4, utilizado en las versiones 4 y 3GS del terminal, así como en el iPad. Apple dará un empujón de esta forma a la potencia de su smartphone, aunque quizá lo más importante sea la nueva capacidad gráfica con un núcleo SGX543MP2 (una versión que combina dos núcleos SGX543), que hará posible videoconferencias de alta calidad.
Al igual que el iPhone 5, el iPad 2 también recogerá estas mejoras, que suponen el paso del núcleo SGX535 a la familia SGX543, lo que supone una procesamiento el doble de potente que el del iPad a la misma velocidad de reloj. El codificado y decodificado de vídeo incrementará sus posibilidades gracias a la aceleración por hardware.
Según recoge AppleInsider, estas características permitirán al iPhone 5 y al iPad 2, con su doble cámara, realizar videoconferencias de alta calidad. La compañía de Cupertino pretende así dar un empujón al procesador, que lleva siendo el mismo desde que se lanzó la versión 3GS del smartphone.
El iPhone 5 necesitará su propio iOS
La nueva actualización de la plataforma móvil de Apple, lanzada de momento sólo para desarrolladores, lleva camino de ser la que gobierne el iPad 2 en sus primeros momentos de vida (al igual que ocurrió con el primer tablet hasta la aparición de iOS 4.0). Sin embargo, cabría esperar que Apple lanzara una nueva versión del sistema coincidiendo con la aparición del iPhone 5.
iOS 4.3 parece más orientado al iPad, así como la anterior actualización del sistema operativo móvil, que al smartphone de Apple. Como viene siendo tradición, la compañía podría aprovechar el lanzamiento del iPhone 5 para sacar una gran actualización de la plataforma, destinada a ser iOS 5.0.


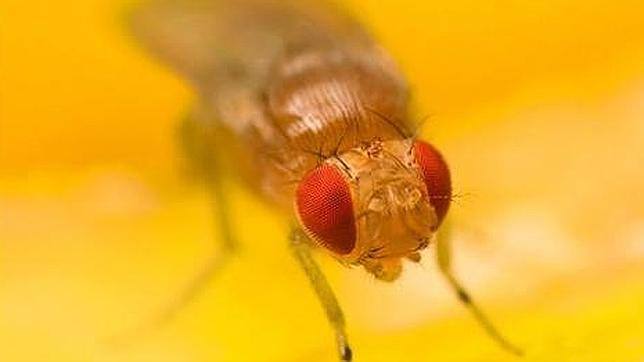
Una mosca puede revolucionar la informática

Un nuevo algoritmo basado en la forma en que la humilde mosca de la fruta organiza sus diminutos pelos -sus sensores para «captar» el mundo- puede proporcionarnos la solución a los problemas de las redes inalámbricas.


Los expertos de la Universidad de Carnegie Mellon, en Pittsburgh (Estados Unidos), aseguran que un nuevo algoritmo basado en la forma en que la humilde mosca de la fruta organiza sus diminutos pelos -verdaderos sensores que les permiten “sentir” el mundo- tiene el potencial de proporcionarnos la solución a los problemas que plantean las redes inalámbricas. Parece que la forma en que se organiza el sistema nervioso del insecto es mucho más simple y eficiente que cualquier red elaborada por los humanos.
Desde sus inicios, la informática mantiene una extraña relación con los insectos. Desde los primeros “bugs”, pequeñas polillas que buscando el calor de los tubos de vacío provocaban cortocircuitos capaces de paralizar ordenadores más grandes que una casa, hasta los más modernos y sofisticados “gusanos” que, junto a otras alimañas cibernéticas, pueden derribar enormes redes de ordenadores reproduciéndose como lo haría un ser vivo, los expertos en informática han buscado en el reino animal ejemplos o ideas en las que basar sus diseños. En las últimas horas se ha conocido un trabajo elaborado por los expertos de la Universidad de Carnegie Mellon, en Pittsburgh (Estados Unidos) que indicaría que la mosca de la fruta -uno de los insectos mejor comprendidos por el hombre- podría tener la clave para solucionar algunos de los problemas mas complejos de la informática distribuida.
 
Organizados como insectos
 
Mantener comunicados de forma eficiente dos ordenadores es una tarea trivial. Pero a medida que el número de integrantes de la red comienza a aumentar, la situación se complica rápidamente. Las redes actuales, que en muchos casos superan los cientos o incluso miles de ordenadores, suelen ser muy poco eficientes, sobre todo cuando el sistema de conexión elegido es el inalámbrico. El trabajo, que se ha publicado en el último ejemplar de la revista “Science”, muestra cómo los investigadores se inspiraron en la forma en la que la diminuta mosca de la fruta organiza sus diminutas “antenas” -los “sensores” que la “conectan” con el mundo- para conseguir mejores aplicaciones de computación distribuida. Al igual que en una red de ordenadores basada en la arquitectura cliente-servidor, las células del sistema nervioso de la mosca de la fruta se organizan de tal manera que un pequeño porcentaje de ellas funcionen como “centros” que proporcionan las conexiones necesarias con las demás células nerviosas.
Los expertos han creado un algoritmo informático que imita esta forma de trabajo, y descubrieron que esta manera de organizarse puede utilizarse para optimizar aquellas redes de ordenadores en las que el número y posición de los nodos que la componen no están rígidamente establecidos. Las redes WIFI, los sistemas de recolección de datos basados en sensores inalámbricos o grupos de robots autónomos pueden beneficiarse de lo aprendido de la mosca de la fruta.
Los ingenieros ha desarrollado varias formas de “controlar” las conexiones que hacen posible la existencia de las redes informáticas distribuidas. Desde la búsqueda de datos en internet hasta la elaboración automática de informes a partir del contenido de diversas bases de datos, los sistemas implementados por el hombre parecen ser innecesariamente más complejos que el que la naturaleza ha proporcionado mediante la evolución al sistema nervioso de la mosca. Los autores del trabajo aparecido en Science creen que podrán imitar la forma en que la mosca de la fruta utiliza sus pequeños “pelos” para detectar el mundo exterior y la forma en que esos datos son utilizados por una célula nerviosa denominada precursor del órgano sensorial (POS). Cada POS se conecta a otras células nerviosas que tiene a su alrededor, pero nunca con otro POS. Podría crearse un sistema de cómputo distribuido en el que un pequeño grupo de microprocesadores se comunica velozmente con el resto de los integrantes de la red, algo a lo que los teóricos refieren como conjunto independiente máximo (CIM). Al igual que en el sistema nervioso del insecto, cada unidad de computo que integra la red es un líder, un miembro del CIM, o está conectado a él, pero los líderes no se conectan entre si.
Simple y práctico
Durante décadas los ingenieros han buscado la mejor forma de conectar entre sí los miembros de una red. Ahora sabemos cómo lo hace el insecto: durante el desarrollo de la mosca a lo largo de las fases de larva y crisálida, su sistema nervioso utiliza un método probabilístico para seleccionar cuales de sus células que se convertirán en POS. Si bien las células no tienen información sobre cómo están conectadas entre sí, a medida que algunas de ellas se van convirtiendo en POS generan señales químicas que indican a las células cercanas que no deben convertirse también en POS. Este proceso continúa hasta que todas las células son o bien POS, o bien vecinas a una POS. En ese momento, la mosca deja de ser una crisálida.
La principal diferencia que existe entre el sistema utilizado por la mosca para crear su “red” y los algoritmos utilizados por el hombre en los últimos 30 años para conectar sus ordenadores estriba en que en el insecto la probabilidad de que cualquier célula se autoseleccione como POS aumenta en función del tiempo. En un algoritmo típico de CIM utilizado en las redes informáticas aumenta como una función del número de conexiones. El método de la mosca no requiere conocer al detalle la forma en que se organiza la red, sino que la topología de la misma evoluciona de forma de ser la más simple posible.
¿Como no hemos sido capaces de hacer algo así antes? Al fin y al cabo, se trata de algo muy lógico, y que la naturaleza ha logrado “desarrollar” sin utilizar nada más complejo que el método del ensayo y el error. Noga Alon, experto en matemática e informática de la Tel Aviv University y del Institute for Advanced Study de Princeton, Estados Unidos, coautor del artículo, reconoce esta situación explicando que “se trata de una solución tan simple e intuitiva que cuesta creer que no hayamos descubierto su valor 25 años antes.” Junto a otros investigadores que participantes del proyecto -Ziv Bar-Joseph, Yehuda Afek, Naama Barkai, Eran Hornstein y Omer Barad- Alon a conseguido fondos del National Institutes of Health y la National Science Foundation estadounidenses que deberían permitirles convertir toda esta teoría en un sistema práctico. ¿Podrán lograrlo? Ellos creen que sí. Y esperamos que tengan éxito, ya que estas mejoras harán de nuestras redes algo mucho más eficiente
 

Google tiene un nuevo frente abierto en España que se empezará a dirimir hoy en los juzgados. Se trata de un litigio contra la Asociación Española de Protección de Datos que solicita al buscador la eliminación de algunos contenidos en virtud del “derecho al olvido” de los internautas.

Y parece que Google está dispuesto a llegar hasta donde haga falta en este caso, ya que han recurrido ante la Audiencia Nacional las 90 resoluciones ya dictadas que les obligaban a eliminar información publicada hace tiempo en boletines oficiales y medios de comunicación.
Como ejemplo de esa información que exigen que se retire han mencionado la seguridad de personas que han casos de violencia y piden que se elimine la información de la red para no poder ser localizados por los agresores.
Las posturas no podían ser más enfrentadas ya que la AEPD asegura que los contenidos deben ser retirados por un el derecho a la dignidad y al olvido de los internautas, mientras que el buscador ha planteado su defensa asegurando que se trata de un caso de censura y que pretenden coartar el derecho a la libertad en la red.
Desde Google han asegurado que este litigio les preocupa sobremanera ya que temen que siente un precedente “de censura” que se pueda extender por Europa.
Además, se defienden recordando su papel de intermediario y aseguran que “exigir que intermediarios como los motores de búsqueda censuren el material publicado por otros tiene un efecto profundo y negativo sobre la libertad de expresión”, según apuntaba Peter Barron, director de relaciones externas de Google.

Megaupload ha contactado con el portal web TorrentFreak para transmitir su queja y denuncia por el acoso recibido por RIAA y la MPAA. Tanto Megaupload como Rapidshare se enfrentarán a duras batallas legales este año por violación de derechos de autor y por ser responsables de la piratería en Internet. Su filosofía de la descarga directa y el alojamiento anónimo está cada vez más extendida frente a las plataformas P2P.
Megaupload se defiende citando a Google en su comunicado. La compañía de alojamiento en Internet asegura que en esencia no se diferencia mucho del rey de Internet en la cuestión del pirateo:
"Nosotros ofrecemos conectividad entre los usuarios finales y la capacidad de almacenar en la nube, pero no el contenido que allí se sube (como por ejemplo los proveedores de ADSL o los vendedores de disco duro). La mayoría de los servicios públicos de Internet, incluyendo su columna vertebral, no podrían existir si la ley no los protege de la responsabilidad por abusos cometidos por los usuarios, siempre y cuando se cumplan con los requisitos específicos, tales como el procesamiento oportuno de abuso en las comunicaciones.
Somos una herramienta de “doble uso” comparable a una cuenta de correo o una memoria USB. Frente a los contenidos ilícitos, las violaciones de término no son toleradas, pero dependemos de la DCMA para actuar rápidamente y procesar una solicitud de cierre. Nosotros colaboramos estrechamente con los titulares de derechos y los agentes del orden y les proporcionamos acceso directo a la desactivación en tiempo real. Debido a esto, nunca nadie nos demandó por violación de derechos de autor.
Es increíble que por unas cuantas “ovejas negras”, teniendo entre nuestros usuarios a más de 100 millones y 500 empresas titulares con servicios, que se nos tache de ilegítimos. Nos hemos convertido en el estándar para archivos grandes, somos el disco duro más famoso de la nube. Presentamos más copias de seguridad que cualquier otra empresa. Si nosotros somos etiquetados como delincuentes por la RIAA y la MPAA ¿qué pasa con Google y Yahoo!? ¿qué pasa con las ISP? Google probablemente alberga el mayor índice del mundo de contenidos pirateados".

Un 54% de los asesores de empresas españolas considera que Internet no es estratégico ni relevante para su negocio a medio ni largo plazo, según se desprende de la encuesta realizada durante el Foro de Asesores Wolters Kluwer a 1.000 asesores de empresas españolas.
   Así, de acuerdo con el III Barómetro de Coyuntura Tecnológica  promovido por CISS y A3 Software, más de la mitad de los asesores españoles no tiene página web o blog ni participa en redes sociales.
   Por el contrario, un 29% de los participantes cree necesario tener una página web corporativa con buen posicionamiento para que los potenciales clientes les encuentren de una forma más sencilla, mientras que un 38% cree conveniente participar en blogs, comunidades virtuales o redes sociales donde compartir opiniones con expertos del sector.
   Asimismo, un 53% de los asesores admitieron que siguen utilizando las clásicas carpetas de cartón y las de Windows para archivar sus documentos. En esta línea, el 30% de los encuestados afirmó utilizar un software general en su despacho para archivar documentos y sólo un 10% reconoció disponer de uno específico para dicha tarea.
   En cuanto al asesoramiento en materia de protección de datos , el 58% de los asesores contrata los servicios de un tercero a la hora de  aconsejar a sus clientes en el manejo y archivo de datos confidenciales.

La red social permite que las aplicaciones desarrolladas por terceros accedan a los datos privados de los usuarios


Facebook acaba de anunciar en su blog para desarrolladores que a partir de ahora va a permitir el acceso a «las direcciones y números telefónicos de los usuarios», como parte del objeto gráfico. O lo que es lo mismo, las aplicaciones desarrolladas por terceros tendrán acceso a la información de contacto de los usuarios.
«Como ésta es una información sensible” se lee en el post, “(…) el permiso tendrá que ser explícitamente autorizado a tu aplicación por el usuario o a través de nuestros diálogos estándar de permiso». Recomendamos revisar los ejemplos de los diálogos estándar de permiso y que cada uno decida si es un mecanismo suficiente.
Como el blog especializado All Facebook señala, lo importante aquí es que Facebook ahora va a compartir una serie de datos que antes no compartía. En este ejemplo de caja de diálogo, sólo hay un par de elementos, pero hay otras cajas similares que contienen más. Jacki Cohen escribe: «(Los usuarios) probablemente no notarán que se han agregado las palabras ‘dirección actual y número de teléfono’ al texto, y seguramente harán clic en ‘permitir’ sin realmente darse cuenta de que están otorgando más acceso que nunca».
Menús confusos
Afortunadamente, no se puede acceder a este tipo de información no puede a través de los contactos y su actividad despreocupada, como, de hecho, sí sucede con otros datos del perfil. De acuerdo con el post de Facebook, «estos permisos sólo permiten acceso a la dirección y número telefónico de un usuario, no a los de sus amigos».
Estas nuevas reglas del juego cambian la percepción que algunos usuarios tienen sobre las aplicaciones de Facebook, o al menos la cambiarían si fueran conscientes que cualquier aplicación que ejecuten puede acceder a estos datos. Esta información es muy golosa para los publicistas, imaginemos una aplicación que mediante preguntas o juegos obtiene datos sobre los gustos y preferencias de consumo.
Seguramente algunos usuarios no encuentran ningún inconveniente en que sus datos estén disponibles, sin embargo otros se sentirán muy incómodos y Facebook debería de establecer un mecanismo en el que no haya ninguna duda sobre la información que se ofrece.
Siempre hemos tenido muy clara la relación de Facebook con la privacidad, sin embargo si estuviera perfectamente claro que estos datos son disponibles, muchos usuarios querrían borrar las aplicaciones de Facebook y probablemente por eso es que ni los diálogos son claros ni desde la red social se hace mucho eco de la noticia.


La explosión de la telefonía móvil avanzada

Desde hace un par de años vivimos una auténtica explosión de la telefonía móvil avanzada. Los terminales tienen mejores y más grandes pantallas y funcionalidades que hasta hace poco eran o un sueño o directamente estaban implementados en otros equipos más avanzados.
Todo el mundo da por supuesto que en unos años (Duncan Stewart lo establece para 2014) el teléfono móvil será el dispositivo principal con el que accederemos a Internet, y eso significa como mínimo acceso directo a información y servicios. Si luego pensamos en la explosión de aplicaciones para los nuevos teléfonos, ¿quién es el loco/a que piensa en un límite para lo que puede hacer el móvil por nosotros?

La semana pasada vivimos precisamente uno de esos momentos en los que a todos nos viene a la cabeza la frase nada es imposible. Android, que poco a poco va erigiéndose como el sistema operativo del futuro, se volvía a llevar el gato al agua de la mano de Google, que llevaba a este sistema operativo la traducción simultánea de conversaciones.

image0.png

Y qué decir de las posibilidades del nuevo Google Googles, que ha demostrado que con una simple foto que hagamos a un Sudoku, él se encarga de resolvérnoslo. ¿Seguimos? Realidad aumentada, geolocalización con acceso a servicios de forma directa, pagar, control de coches, domótica …

Con la tecnología de Blogger.